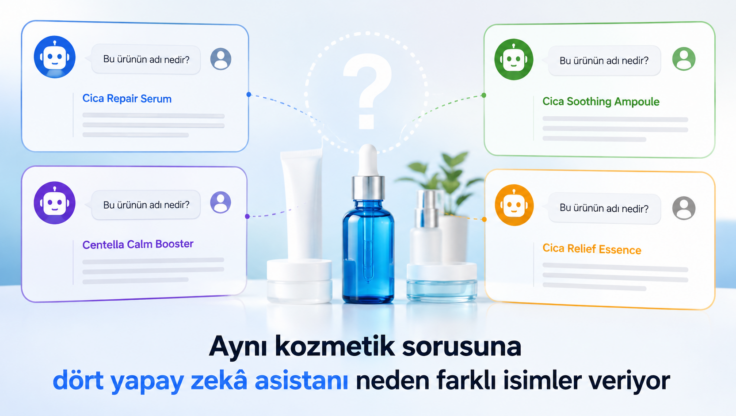
Türk kozmetik markası soran bir alışverişçi, ChatGPT’den aldığı listeyi Gemini, Claude ve Grok’un listeleriyle yan yana koyduğunda aynı isimleri aynı sırada bulmuyor. Herm.io’nun kozmetik sektörü için yürüttüğü yapay zekâ görünürlük ölçümü bu farkı sayıya döktü. Dört asistana 27 Türkçe soru beşer kez yöneltildi, ortaya çıkan 540 yanıtta 138 marka izlendi ve dört binden fazla marka anılması kaydedildi.
Toplu tabloda en çok öne çıkan isim The Purest Solutions oldu. Marka yanıtların yüzde 54’ünde öne çıktı ve 96,3 AI Görünürlük Skoru aldı. Bu, dört asistanın da aynı ismi ilk sıraya yazdığı anlamına gelmiyor. Claude kendi yanıtlarında Farmasi’yi birinci sıraya taşıdı. Aynı sorular, aynı dil, aynı ölçüm, farklı bir birinci sıra.
Ayrışma tam olarak nerede ortaya çıkıyor
Dört asistanın yanıtları birleştirildiğinde ortaya çıkan görünürlük skorları şöyle sıralanıyor.
| Marka | AI Görünürlük Skoru |
| The Purest Solutions | 96,3 |
| Golden Rose | 85,6 |
| Flormar | 78,6 |
| Pastel | 75,3 |
| Farmasi | 68,3 |
| Dermoskin | 64,8 |
| Cosmed | 63,1 |
Tablonun en üstündeki isim bile her yanıtta öne çıkmıyor. The Purest Solutions yanıtların yüzde 54’ünde ilk plandaysa, geri kalan yaklaşık yüzde 46’lık kısımda sahneyi başka markalara bırakıyor. Kozmetikte tek bir ismin tüm cevabı doldurduğu bir tablo yok.
Claude’un birinci sıraya koyduğu Farmasi de bu görünür grubun içinde zaten yer alıyor. Ayrışma, bir asistanın tamamen başka markalar üretmesi biçiminde değil, aynı dar isim havuzunun içinde sıranın değişmesi biçiminde ortaya çıkıyor. İzlenen 138 markanın yalnızca 31’i yanıtların yüzde 5’inde anılma eşiğini geçebildi. Dört asistan büyük ölçüde aynı isimleri sayıyor, ayrıştıkları nokta bu isimlerden hangisinin öne geçtiği.
Tek bir asistanın cevabı neden yeterli bir liste değil
Ölçümün tasarımı bu oynaklığı baştan hesaba katıyor. Her soru her modele beş kez soruldu, çünkü bir asistanın aynı soruya arka arkaya verdiği yanıtlar da birebir aynı olmuyor. Tek bir sohbette alınan tek bir liste, o modelin genel eğilimini değil o anki bir örneğini gösteriyor.
Herm.io’nun yayımladığı yapay zekada en çok önerilen kozmetik markaları listesi de tek bir denemeden değil, 540 yanıtın toplamından çıkıyor. Sıralamayı okunabilir kılan şey tekrarların kendisi: aynı soru yeterince çok kez sorulduğunda tek tek yanıtların oynaklığı azalıyor ve modelin eğilimi görünür hale geliyor.
Listeye bakan taraf için bu üç pratik ayrıma dönüşüyor.
- Bir asistanda üst sırada görünmek, dört asistanın hepsinde görünmekle aynı şey değil
- Aynı asistandan farklı zamanlarda alınan iki liste birbirinden farklı çıkabilir
- Tek bir yanıta bakarak yapılan karşılaştırma, markanın genel görünürlüğünü değil yalnızca o yanıtı ölçer
Hangi asistanın listesi doğru kabul edilmeli
Ölçüm bu soruyu cevaplamıyor, çünkü karşılaştırılacak bir doğru liste yok. Asistanların verdiği isimler, Türkiye’de hangi kozmetik markasının gerçekten daha çok tercih edildiğini gösteren bağımsız bir sıralamayla eşleştirilmiş değil. Kayıt altına alınan şey asistanların ne söylediği; söylediklerinin piyasayı ne kadar iyi yansıttığı bambaşka bir soru.
Dört asistandan birini doğru, diğerlerini yanlış saymak yerine dördünü ayrı birer görünürlük yüzeyi gibi okumak daha yararlı oluyor. Bir marka açısından asıl bilgi hangi modelin haklı olduğu değil, kaç modelde ve ne sıklıkla göründüğü. Yalnızca tek bir asistanda üst sıralara çıkan bir isim, ölçümün tamamında aynı ağırlığı taşımıyor.
Sıralama neyi ölçüyor, neyi ölçmüyor
Skor tablosu markaların ürün kalitesini, formül tercihlerini ya da müşteri memnuniyetini değerlendirmiyor. Ölçtüğü tek şey görünürlük: bir marka adının Türkçe kozmetik sorularına verilen yanıtlarda kaç kez ve listenin neresinde göründüğü. Yapay zekâ yanıtlarında sık anılmak bir markanın daha iyi ürün yaptığını göstermez, yalnızca o ismin bu yanıtlarda daha görünür olduğunu gösterir.
Asistanlar arası fark söz konusu olduğunda bu ayrım daha da önem kazanıyor. Farklı modeller farklı isimleri öne çıkarıyorsa, tek bir modelin cevabını sektörün genel görüntüsü gibi okumak yanıltıcı olur. Ölçüm de zaten tek bir modelin cevabını değil, dört modelin toplam davranışını tarif ediyor.
Ayrışmanın derecesi her sektörde aynı değil
Aynı yöntemle ölçülen başka sektörlerde asistanlar birbirine çok daha yakın sonuçlar verdi. Mobilyada 746 yanıt ve 352 marka üzerinde beş asistan büyük ölçüde aynı isimlerde buluştu, İstikbal, Bellona ve Doğtaş birbirine çok yakın bir üçlü oluşturdu ve hiçbir model ilk sırayı değiştirmedi. Anne ve bebek ürünlerinde Chicco beş asistanın dördünde en çok anılan marka oldu.
Kozmetikte tablo daha bölünmüş. Dört asistandan biri farklı bir ismi öne çıkardığında, kategori için tek bir uzlaşılmış cevaptan söz etmek zorlaşıyor. Bu yüzden kozmetikte “yapay zekâ hangi markayı öneriyor” sorusunun karşılığı tek bir marka adı değil, hangi asistanın hangi ismi öne çıkardığını gösteren bir dağılım.